안은남 사진

안은남 (Eunnam Ahn)

AI 엔지니어 · LLM / RAG · 평가 설계

미국 대학원에서 편미분방정식 해석해, 인공신경망 대리 모델, 시계열 예측 모델을 직접 만들고 검증하며 수학적 모델링 연구를 했습니다. 이후 AI 엔지니어로 전환해, LLM과 RAG가 내놓은 답을 측정하는 평가 코드를 만들어 왔습니다. SAVERS에서는 답변을 걸러내는 검증기를 시험하는 평가셋과 채점 스크립트를, 입찰메이트에서는 95문항 골든셋과 유형별 자동 채점기를 직접 작성했습니다.

영어로 논문을 쓰고 학부 수업을 가르쳐서 영어 발표, 토론, 문서 작성이 자유롭습니다 (TOEIC 985).

프로젝트

2026.07 – 2026.09

SAVERS · 재난 취약계층 맞춤 대피 안내 서비스

팀장 · PM · 평가와 인프라 (4인 팀) · K-디지털 트레이닝 해커톤 2026 · FastAPI, LangChain, OSMnx, NetworkX, AWS EC2, FCM
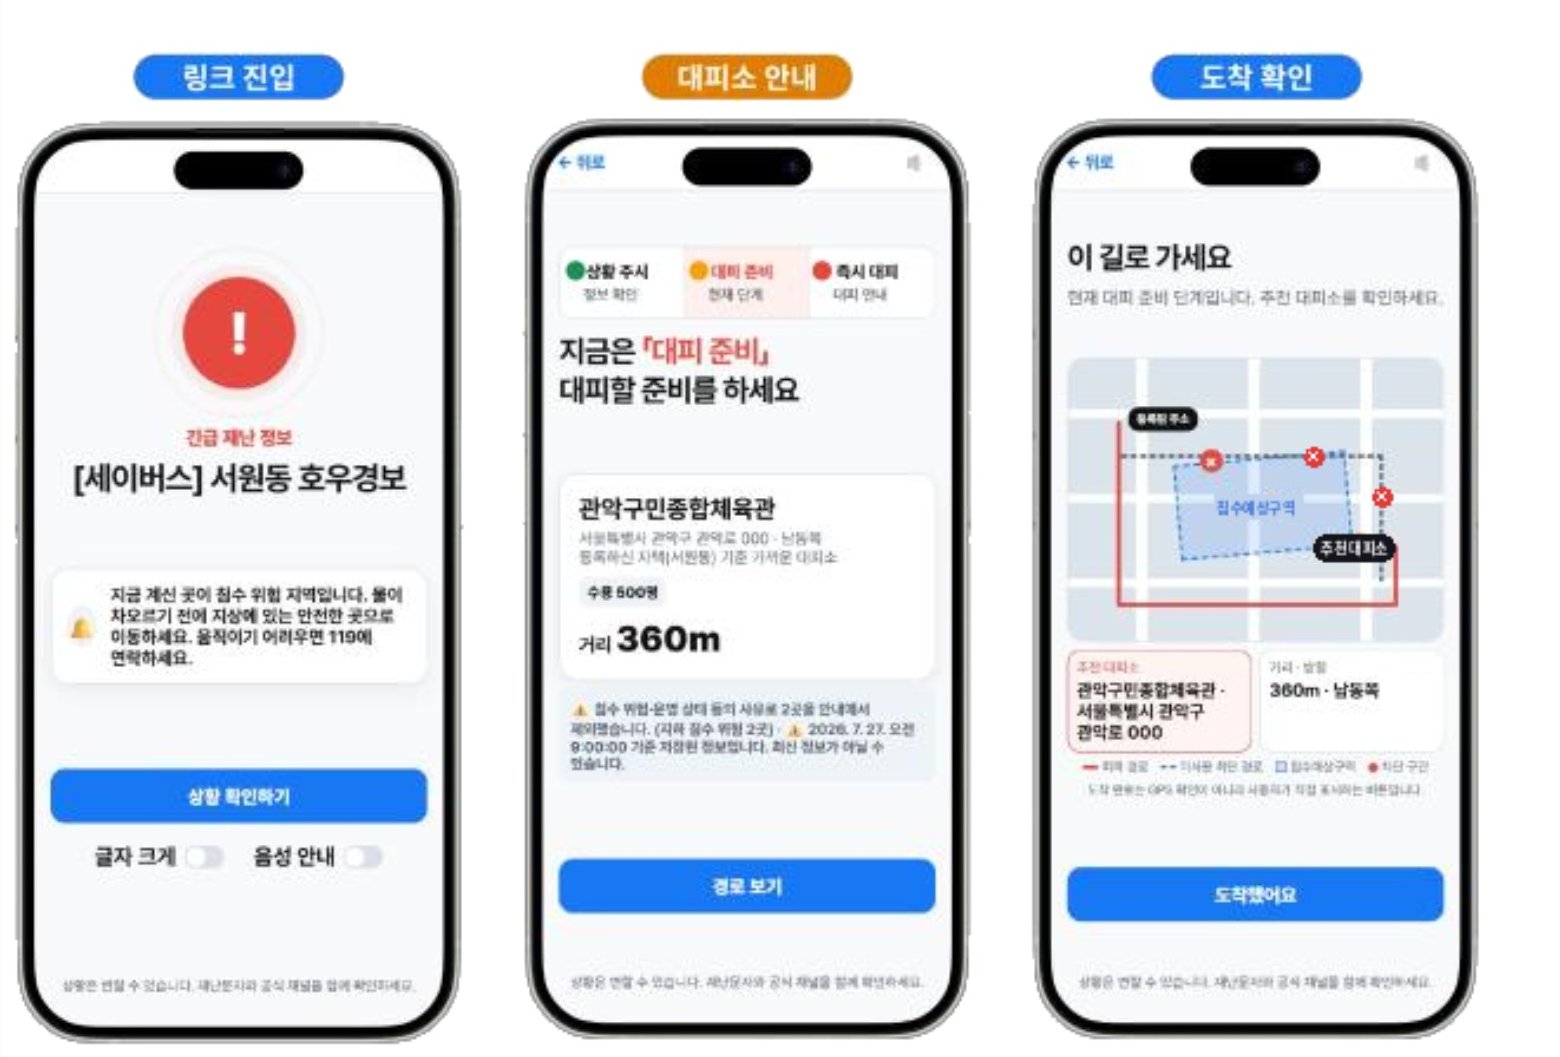
SAVERS 서비스 화면 3개: 긴급 재난 정보 링크 진입, 대피 단계와 추천 대피소 안내, 대피 경로 지도와 도착 확인
서비스 화면: 알림 링크 진입 → 대피소 안내 → 경로 확인·도착 확인. 대피소와 경로는 규칙 코드(OSMnx·NetworkX)가 정하고, LLM은 정해진 결과를 설명만 합니다.
  • 문제: 홍수 경보는 모두에게 같은 문자를 보내지만, 혼자 판단·대피하기 어려운 주민에게는 앱 설치나 상시 위치 추적 없이 개인별 안내가 필요
  • 담당 업무: 평가 코드(보호자 응답 골든셋 40건(답변 35·거절 5), 적대 회귀 12건, 거절 프로브 34건, 채점 스크립트)와 인프라 코드(FCM 실발송 연결, AWS 배포, 자동 품질 검사 CI) 담당, 설계 결정 기록(ADR) 관리, 논문 제1저자 집필
  • 대피소 선택과 도보 경로는 LLM에 맡기지 않고 규칙 기반 코드(OSMnx/NetworkX)로 계산해, LLM은 이미 정해진 결과를 설명만 하도록 설계
  • 검증기는 답변을 주장 단위로 쪼개 이벤트 기록과 대조하고, 통과 기준은 "기록에 없는 내용 0건". 이 검증기를 검증할 평가셋을 작성해, 미리 쓴 정답 문장 35/35가 잘못 막히지 않았고 오답 유도 문장은 처음 8/12만 걸러져 놓친 4건을 분석하고 보강해 12/12. 골든셋 40건 중 30건은 시스템 출력을 먼저 채택한 뒤 계약 문서와 대조해 확정
  • 챗봇이 답해야 할 때와 거절해야 할 때를 모두 측정: 거절 프로브(답해야 할 질문 28건, 거절 대조군 6건)에서 불필요한 거절은 3.6%(1/28)로 낮았지만, 대조군 6건에는 모두 엉뚱한 근거로 답하는 과소거절 6/6(100%)을 찾아냄. 기존 근거 일치 지표로는 드러나지 않는 실패였고, 원인이 검증기가 아니라 앞단 검색에 있음을 확인
  • 지인 52명에게 재난문자와 SAVERS 화면을 차례로 보여 준 설문에서 행동 지침 명확성("지금 무엇을 해야 할지 분명한가", 10점 만점) 3.2 → 8.3점(Wilcoxon p<0.001), "5분 안에 집을 나서겠다" 13% → 60%
  • 고용노동부장관상(장려상, 326팀 중 3위), ACK 2026 논문 제1저자·구두발표
  • 한계: 35/35와 12/12는 정답·오답 문장을 채점에 직접 넣어 잰 값이고, 거절 프로브 측정 당시 생성기는 근거 문장을 그대로 옮기는 오프라인 스텁이라, 실제 생성 모델을 붙인 뒤 다시 측정해야 함
2026.06 – 2026.07

입찰메이트 · 공공 RFP 문서 RAG 질의응답·요약

평가 담당 (5인 팀) · LangChain, FAISS, KURE-v1, EXAONE 3.5, RAGAS

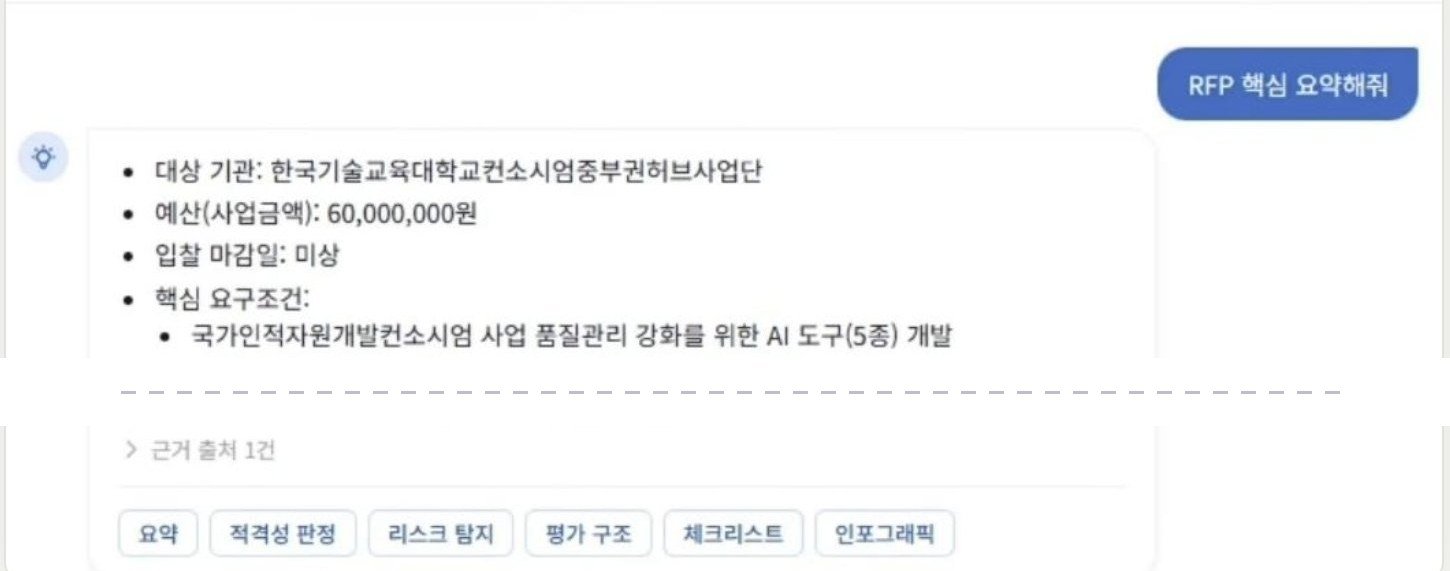
입찰메이트 채팅 화면:
서비스 화면: RFP 핵심 요약 질문에 대상 기관 · 예산 · 요구조건을 정리하고, 답변 아래에 근거 출처를 답니다. (가운데 일부 생략)
  • 문제: HWP/PDF가 섞인 공공 RFP 100건에서 출처를 인용하고, 문서로 답할 수 없는 질문은 거절해야 함
  • 담당 업무: K-means 기반 골든셋 제작, 파싱·청킹 전처리 실험, 임베딩 비교·KURE-v1 전환, RAGAS 평가 설계, 자동 채점 스크립트 구현
  • K-means 클러스터링으로 대표 문서를 골라 골든셋 50건을 만들고, 5개 유형 95문항(19개 RFP)으로 확장해 유형별 자동 채점기 구현
  • 검색·답변 설정 708개 조합을 95문항 개발셋으로 3단계 비교해 최종 설정 MRR 0.977, Hit@4 1.0, 거절 19/19 (설정 선택과 평가에 같은 셋을 써서 새 질문에서는 낮을 수 있음)
  • OpenAI 대신 무료 로컬 조합(KURE-v1 + dense k=4 + EXAONE 3.5, GCP VM의 Ollama)으로 전환해 평균 응답 3.6초, 외부 API 호출 비용 0원
  • 점수가 0.3에서 멈춘 원인이 모델이 아니라 골든셋 오류였음을 찾아 수정했고, 입력 길이 제한(4,096토큰) 때문에 근거가 잘리던 문제를 8,192토큰으로 늘려 해결, 효과 없이 응답만 21초 늦추던 리랭커는 제거
  • 한계: 조합 선택과 평가에 같은 골든셋을 써서, 처음 보는 질문에서는 점수가 더 낮을 수 있음
2026.08

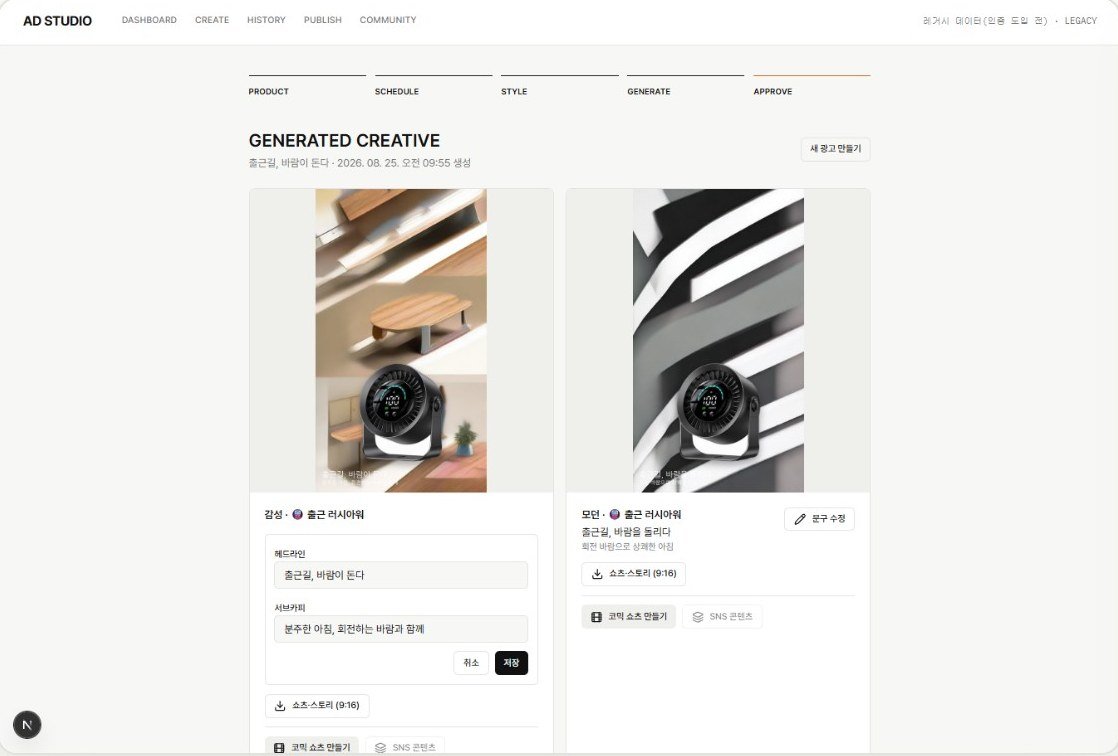
AI 광고 스튜디오 · 소상공인용 광고 이미지·문구 생성

팀장 · PM · 평가 기준 설계 (5인 팀) · SDXL, ControlNet, IP-Adapter, FastAPI, GCP L4

AI 광고 스튜디오 생성 결과 화면: 같은 선풍기 제품으로 감성·모던 톤 광고 이미지 2장과 헤드라인·서브카피 편집칸
서비스 화면: 원본 제품은 그대로 두고 배경만 바꾼 톤별 광고 시안과 문구 편집. 사람이 승인한 결과만 쇼츠로 만들어 YouTube에 예약 게시합니다.
  • 문제: 시간대·채널마다 광고 이미지를 새로 만들어야 하지만, 사진 속 제품은 절대 바뀌면 안 됨
  • 담당 업무: 팀장·PM으로 4주 스프린트 운영, 평가 기준(eval_criteria) 설계, 최종 보고서 총괄
  • 제품 보존율을 1순위 지표로 정의: 원본 제품을 생성한 배경 위에 합성해 제품을 지키고, 제품 영역 CLIP 유사도 0.85 이상 검사 후 사람이 다시 확인하는 판정 기준을 설계해 대표 조합 4/4 통과(대규모 평가는 미실시)
  • 팀 성과: LCM-LoRA로 배경 생성 17.47초 → 1.72초(약 10배), 이미지 한 장 전체 처리 5.97초, 자동화 테스트 486건 통과, 사람이 승인한 이미지만 13초 쇼츠로 만들어 YouTube 예약 게시
  • 한계: 정밀 이미지 비교(SSIM)와 블라인드 사람 평가는 하지 못해, 다음 단계 과제로 보고서에 명시
2026.04 – 2026.05

PillScope · 경구약제 이미지 객체 탐지

팀장 · PM · 모델 실험 (5인 팀) · YOLOv11, RT-DETRv2, RF-DETR, COCO

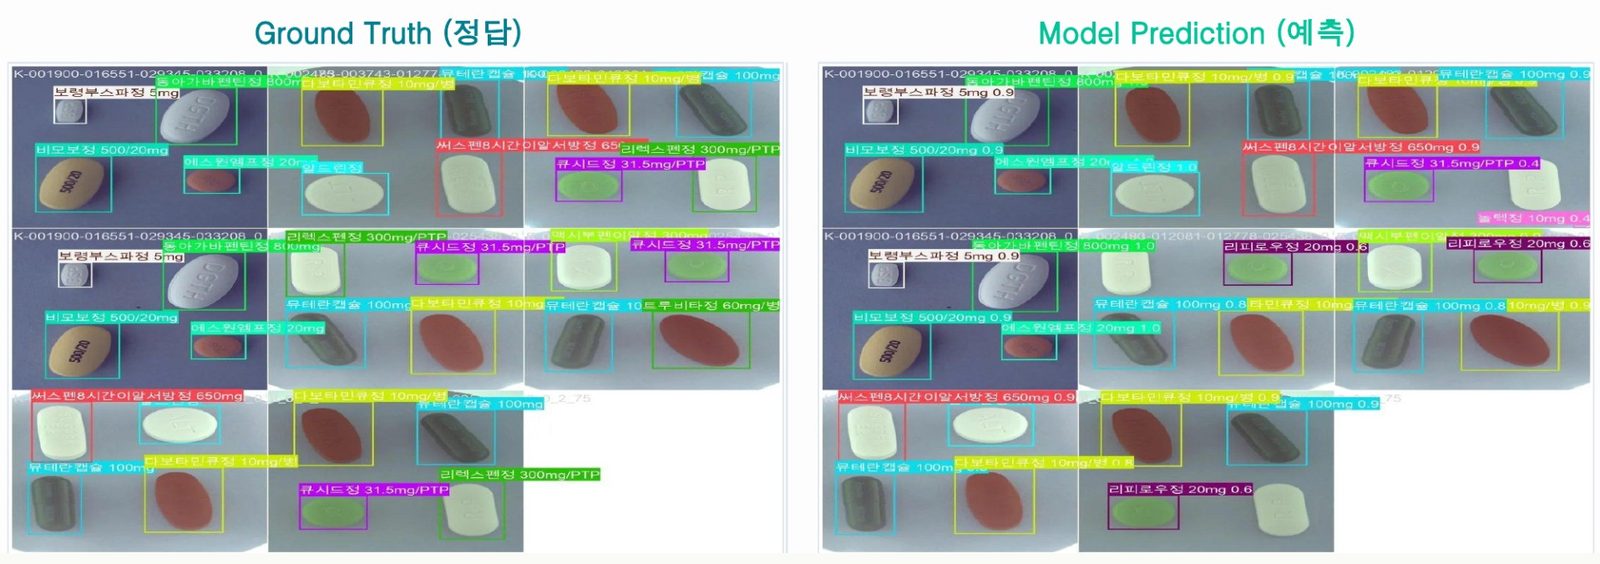
알약 이미지의 정답 박스(왼쪽)와 모델 예측 박스(오른쪽) 비교
왼쪽 정답, 오른쪽 모델 예측 · 희귀 클래스(큐시드정)까지 탐지
  • 문제: 외형이 비슷한 56개 클래스, 학습 이미지 186장, 51배 클래스 불균형(153 vs 3), 이미지당 최대 4개 알약
  • 담당 업무: PM, COCO → YOLO 공용 파이프라인 구축, YOLOv11l 학습, DETR 계열 실험, Crop & Paste 증강
  • 촬영 옵션만 다른 비슷한 사진을 같은 split으로 묶어 점수가 부풀려지지 않도록 데이터 누수 방지
  • 데이터가 적은 알약을 오려 붙이는 증강으로 학습 이미지를 186장 → 1,026장으로 늘려 mAP@0.5 0.886 → 0.964, 인터넷 알약 이미지를 대회 배경에 합성해 한 번도 찾지 못하던 희귀 알약까지 탐지
  • 모델 4종 7단계 실험에서 YOLOv11l이 대회 지표인 검증 mAP@[0.75:0.95] 0.936으로 RF-DETR(0.882)·RT-DETRv2(0.883)보다 높았고(모델별 학습 이미지 수가 달라 통제 비교는 아님), Kaggle 제출은 conf 임계값 조정과 3모델 WBF 앙상블로 첫 제출 0.851 → 0.936
2019.09 – 2019.12

생의학 초록 문장 분류 · BERT·SciBERT 임베딩 비교

Penn State IST 597 딥러닝 수업 프로젝트 · 2인 팀(동일 기여) · 지도: C. Lee Giles 교수 · TensorFlow

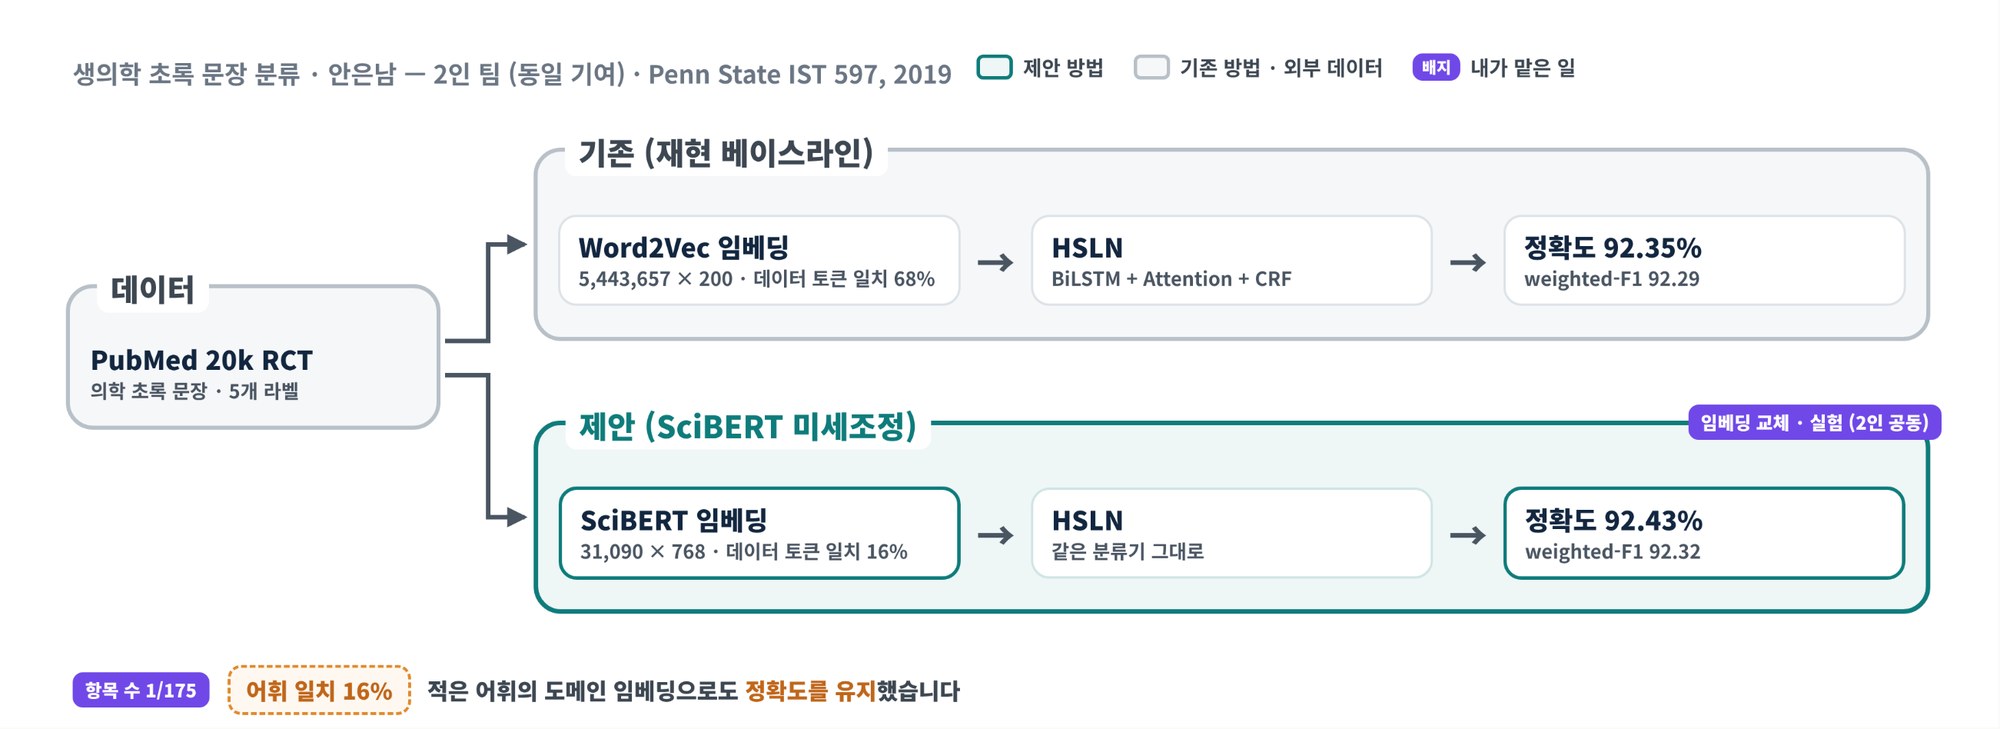
PubMed 20k RCT 데이터로 기존 Word2Vec 임베딩 + HSLN(정확도 92.35%)과 SciBERT 임베딩 + 같은 HSLN(정확도 92.43%)을 비교한 구조도
HSLN 분류기와 데이터는 그대로 두고 임베딩만 Word2Vec에서 SciBERT로 교체: 데이터 토큰 일치율 16%(Word2Vec 68%), 항목 수 1/175로도 정확도 92.35% → 92.43%.
  • 문제: 생의학 논문 초록 대부분이 비구조화되어 있어, 연구자가 방법·결과 등 필요한 정보만 골라 읽기 어려움
  • 담당 업무: BERT·SciBERT에서 단어 임베딩을 추출해 기존 문장 분류 모델(HSLN)의 Word2Vec을 대체하고, 기준선 재현을 포함한 5가지 조건 실험 수행
  • 어휘 수가 약 1/175인 임베딩으로 기존과 같은 수준의 정확도 유지(92.35% → 92.43%, PubMed 20k RCT, 단일 실행), 데이터 토큰 중 사전학습 어휘에 있는 비율이 낮은 점(16%, Word2Vec 68%)을 성능의 한계 요인으로 분석

논문

2026.11

재난 취약계층을 위한 근거 기반 대피 안내 서비스의 설계 및 구현

제1저자, 구두발표(2026.11.06) · 한국정보처리학회 학술대회(ACK 2026) · KIPS_C2026B0142

2018

Multi-Well Analytical Solution for Coning Under Simultaneous Steady-State Flow of Three Phases

제1저자 · 구두발표 · 영문 · SPE Improved Oil Recovery Conference

대학원 연구

The Pennsylvania State University

2021 – 2024

시공간 저류층 데이터와 딥러닝(Seq2Seq-LSTM)을 활용한 원유 생산량 예측

박사 연구 · Seq2Seq-LSTM, 유전 알고리즘 (Python)

  • 위치·시간 데이터를 입력으로 하는 시계열 딥러닝 모델(Seq2Seq-LSTM)을 만들어, 주입량이나 유정 간격 같은 운영 조건이 바뀔 때의 원유 생산량 예측
  • 수평정과 수직정이 섞인 유정 배치를 "등가 유정 간격 밀도"라는 하나의 지표로 표준화해 여러 유전을 같은 기준으로 비교
  • 유전 알고리즘으로 모델 설정을 최적화해 테스트 데이터에서 R² 0.81 이상, 기존 단일 유정 모델보다 높은 정확도
2019 – 2020

실험계획법(DOE)을 결합한 인공신경망 대리 모델 개발

박사 연구 · 인공신경망, 실험계획법(완전요인·내접 중심합성 설계)

  • 오래 걸리는 저류층 시뮬레이션을 대신할 인공신경망 대리 모델을 만들어, 원유 회수 증진 공정의 생산 예측과 위험 평가를 빠르게 수행
  • 실험계획법으로 지하의 불확실한 변수를 모두 반영하면서 필요한 시뮬레이션 횟수를 최소화
  • 테스트 데이터 평균 오차 2% 미만, 최대 오차 8% 미만으로, 기존 시뮬레이터 대신 생산 예측과 위험 분석에 쓸 수 있음을 확인
2015 – 2018

원유와 함께 물·가스가 딸려 나오는 현상의 수학 공식 유도

석사 논문 · 포텐셜 함수 기반 해석해 유도(라플라스 방정식, 중첩 원리), 수치 적분(Newton–Cotes)

  • 원유를 뽑을 때 물·가스가 함께 올라오는 현상을 시뮬레이션 없이 바로 계산할 수 있는 정확한 수학 공식(해석해)으로 유도하고, 물·원유·가스 3상이 동시에 흐르는 경우와 주입정·5점 패턴을 포함한 6가지 유정 배치로 확장
  • 물·가스 없이 뽑을 수 있는 최대 생산량(임계 생산량)을 바로 계산할 수 있게 하고, 모세관압이 이를 크게 낮춘다는 점을 밝혀 수치 시뮬레이터 결과를 검증하는 기준 제시(SPE 2018 제1저자 논문)
2016.02 – 2016.05

원유·물·가스 흐름 시뮬레이터 개발

PNG 512 수치 저류층 시뮬레이션 수업 프로젝트 · 개인 · MATLAB (약 1,000줄)

  • 지하 지층 지도를 60×30 격자로 나누고 원유·물·가스가 시간에 따라 어떻게 움직이는지 계산하는 시뮬레이터를 처음부터 구현(Newton-Raphson 반복 해법, 대형 행렬 해법 GMRES, 유체 물성 표 보간)
  • 매 계산 단계마다 질량 보존을 점검해 오류를 잡도록 설계하고, 정답이 알려진 표준 예제와 결과 일치 확인

학력

2018.08 – 2024.12

박사과정 수료, The Pennsylvania State University

Energy and Mineral Engineering

지도교수 Gregory R. King · 부전공 통계학, 계산과학 · 학점 3.81 / 4.00

2015.08 – 2018.08

석사, The Pennsylvania State University

Energy and Mineral Engineering (Petroleum and Natural Gas Engineering option)

지도교수 Russell T. Johns · 학점 3.71 / 4.00

2009.03 – 2015.02

학사, 한양대학교

자원환경공학과

학점 4.28 / 4.50 · 학과 수석(33명 중 1위), 제2공과대학 차석 졸업

졸업논문: 폴리머 공법 적용 시 원유 생산성·경제성 평가(CMG 시뮬레이션·NPV 분석)

강의, 수상, 자격, 교육

2016 – 2024

대학원 조교

The Pennsylvania State University · 영어 학부 수업

오피스아워·복습 세션 운영 · 과제별 상세 피드백

EME 올해의 대학원 조교상(2017, 학과 조교 약 60명 중 1명 선정)

2019 – 2024

대학원 학생회 공동회장

College of Earth and Mineral Sciences, The Pennsylvania State University

2013.06 – 2013.08

한국석유공사 베트남 사무소 해외 인턴십(8주)

산업통상자원부 자원개발특성화대학 사업 선발

2026

고용노동부장관상(장려상)

제8회 K-디지털 트레이닝 해커톤 · 326팀 중 3위

2026.02 – 2026.08

코드잇 스프린트 AI 엔지니어 10기 수료

팀 프로젝트 3회(객체 탐지, RAG, 생성형 AI)와 해커톤 1회, 팀장 3회 역임

2026.06

데이터분석 준전문가(ADsP)

한국데이터산업진흥원(제49회)

2026.03

TOEIC 985 / 990

Listening 490, Reading 495

2017.03

Engineer in Training (EIT)

미국 NCEES FE 시험 합격(펜실베이니아주) · 등록번호 ET 023429

2013 – 2014

대학생 논문 공모전 3회 입상

GS에너지 3위, 한국광해관리공단·한국환경산업기술원 2위

2013 – 2014

국가 이공계 장학금

4학기 전액

2010.01 – 2011.11

육군 병장 만기제대

기술

AI · LLM
LangChain, RAG(FAISS·BM25·리랭커), KURE-v1 임베딩, EXAONE 3.5(Ollama), OpenAI API
비전
YOLO(Ultralytics), RT-DETR, RF-DETR, COCO 데이터 파이프라인, WBF 앙상블
평가 · 품질
골든셋 설계, 주장 단위 검증, Hit@k·MRR·거절 정확도, RAGAS, CLIP 유사도, mAP, pytest, GitHub Actions CI
수리 · 통계
해석해 유도(라플라스 방정식·중첩 원리), 실험계획법(DOE), 인공신경망 대리 모델, 유전 알고리즘, Seq2Seq-LSTM 시계열 예측, 수치 적분, 편미분방정식(PDE) 수치해석·시뮬레이션(MATLAB)
백엔드 · 인프라
Python, FastAPI, Docker Compose, AWS EC2, GCP(L4 GPU), FCM 웹푸시
ML · 데이터
PyTorch, TensorFlow, Scikit-learn, Pandas, NumPy, Matplotlib, OSMnx, NetworkX